GitHub Blog·重要度 72·掲載 2026/7/10 02:24
ワンポイントマージ後のコード変更を自動でドキュメントPR化し公開までの遅れを解消
GitHub Blogは、AspireチームがGitHub Agentic Workflowsを使って、コードの変更がマージされた後にSME(subject matter expert)がレビューするドキュメントのプルリクエストを自動生成する仕組みを紹介しました。リリースとドキュメント更新の間に生じがちなタイムラグを解消することを目指した取り組みです。

Cloudflare (Bluesky)·重要度 72·掲載 2026/7/10 02:22
ワンポイントCloudflareとOpenAIがWebインデックス改善の研究パイロットを開始
Cloudflareは公式Blueskyアカウントで、OpenAIとの共同研究パイロットを発表しました。Cloudflareのグローバルネットワークが持つ信号とOpenAIの最先端検索技術を組み合わせ、Webインデックスの精度・速度・網羅性向上を目指す取り組みです。詳細な仕組みや提供時期はまだ明らかにされていません。
tech/ai news
OpenAI News·重要度 72·掲載 2026/7/10 02:22
ワンポイント人気ベンチマークSWE-Bench Proの信頼性に疑問符
OpenAIが公開した新しい分析によると、AIモデルの評価に広く使われているコーディングベンチマーク「SWE-Bench Pro」に問題が見つかったとのことです。これにより、同ベンチマークの信頼性と正確性について懸念が示されています。
tech/ai news
Hacker News (trusted domains)·重要度 72·掲載 2026/7/10 02:21
ワンポイントOpenAIのコーディング評価論、HNで235ポイント・87コメントの議論に
OpenAIが公式ブログで「Separating signal from noise in coding evaluations」というタイトルの記事を公開しました。コーディング能力を測るベンチマーク評価における信号とノイズの区別という論点を掲げたもので、Hacker Newsでは235ポイント・87件のコメントを集める議論に発展しています。
tech/ai news
OpenAI News·重要度 75·掲載 2026/7/10 02:21
ワンポイント新世代音声モデル「GPT-Live」がChatGPT Voiceを支える
OpenAIは新世代の音声モデル「GPT-Live」を発表しました。自然な人間とAIの対話を実現することを目的としており、すでにChatGPT Voiceの内部で稼働しています。詳細な技術仕様は公開情報の範囲では限られています。
Vercel Blog·重要度 75·掲載 2026/7/10 01:55
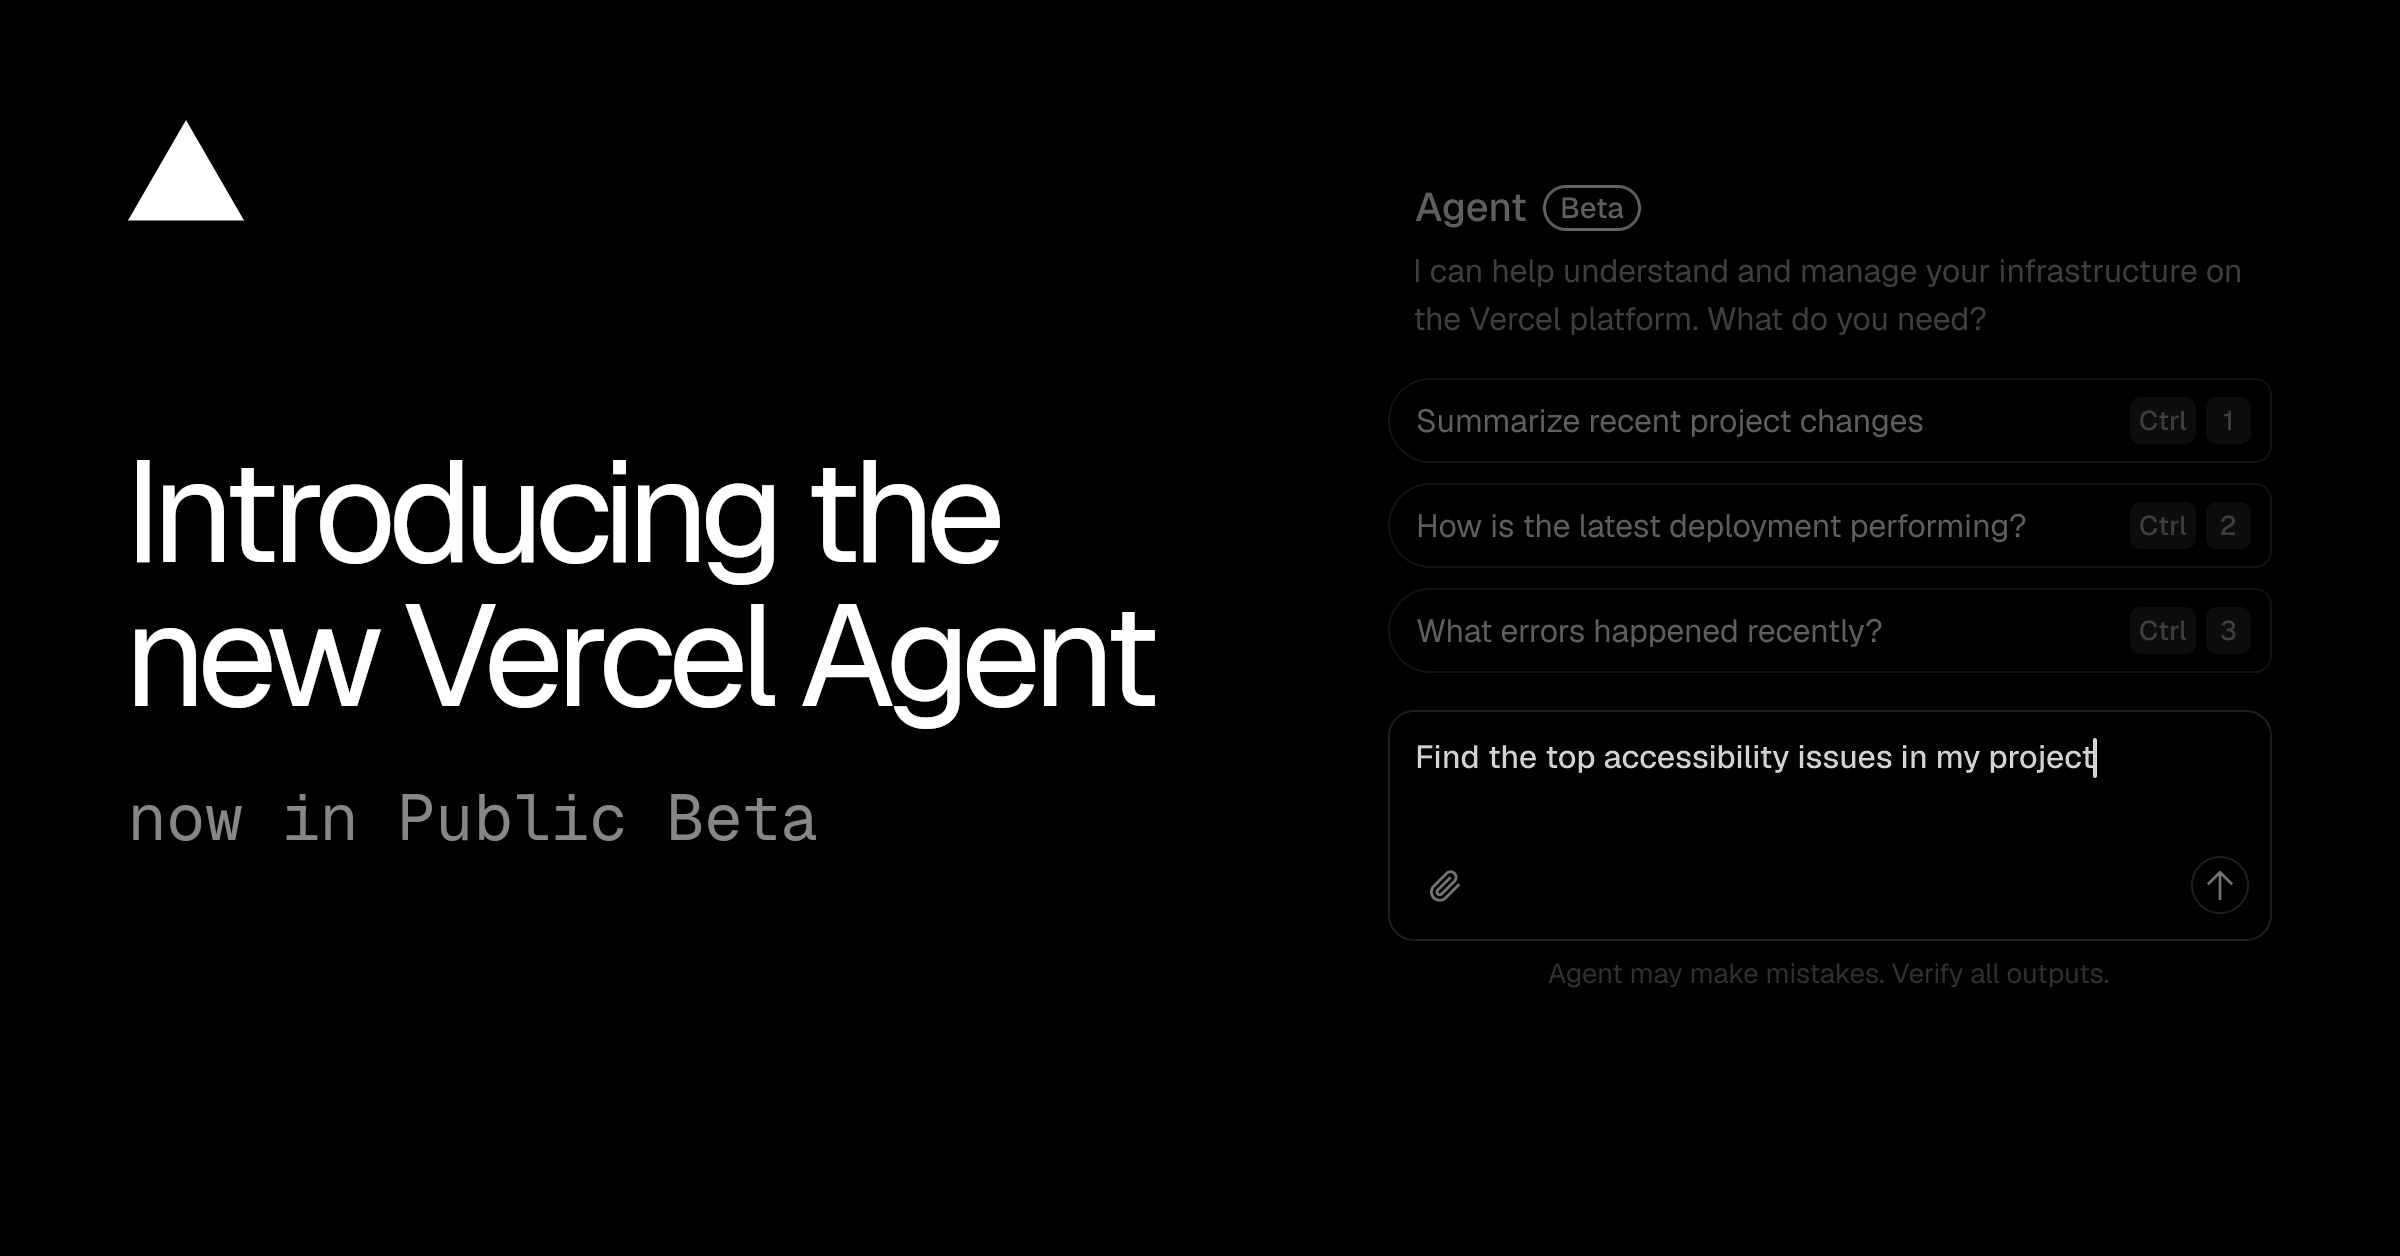
Vercelは、これまでPRレビューやアラート対応を担っていた「Vercel Agent」を拡張し、ダッシュボードから本番環境の調査・質問応答・承認制のアクション実行までできるようにしました。独自IDによる読み取り専用デフォルトと、実行内容ごとに権限を発行する新しい許可モデル、そしてサンドボックス実行によって、危険を抑えつつ本番に近づけるエージェントを実現しています。Pro・Enterpriseプランのチームに段階的に展開中です。

Hacker News (trusted domains)·重要度 75·掲載 2026/7/10 01:54
ワンポイントtransformersのvLLMバックエンドがネイティブ実装並みの推論速度に到達
Hugging Faceは、vLLM上でtransformersのモデル実装を利用する「transformersモデリングバックエンド」を改良し、vLLM専用に書かれたネイティブ実装と同等かそれ以上の推論速度を実現したと発表しました。torch.fxによる静的解析とASTによるコード書き換えで、推論に最適化されたレイヤー融合を実行時に自動適用する仕組みです。Qwen3の複数モデルでの検証結果や、開発者への実務的な影響を紹介します。
Hacker News (trusted domains)·重要度 75·掲載 2026/7/10 01:54
ワンポイント1回の訓練で危険知識を着脱可能にする新手法GRAM
AnthropicはAE Studioとの共同研究で、ウイルス学やサイバーセキュリティなど悪用可能な知識だけをモデルの特定モジュールに閉じ込め、後から着脱できる手法「GRAM」を発表しました。従来のデータフィルタリングでは用途ごとに複数モデルを訓練する必要がありましたが、GRAMなら1回の訓練で複数の構成を作り分けられます。まだ実験段階の研究であり、Claudeの本番モデルには未適用です。

Hacker News (trusted domains)·重要度 75·掲載 2026/7/10 01:52
ワンポイント活性化21Bで2〜5倍規模モデルに匹敵する性能を実現
Tencent Hunyuanチームが、295Bパラメータ・活性化21BのMixture-of-Experts(MoE)モデル「Hy3」をHugging Face等で公開しました。4月末公開の「Hy3 Preview」から50以上のプロダクトのフィードバックを取り込み、後段学習を強化した結果、2〜5倍の規模を持つフラッグシップ級オープンソースモデルに匹敵する性能を実現しています。ツール呼び出しの安定性やハルシネーション抑制など、実運用面での改善も大きな特徴です。
tech/ai news
Hacker News (trusted domains)·重要度 75·掲載 2026/7/10 01:52
ワンポイント「GPT‑Live」公開も、現時点で詳細は不明のまま
OpenAIの公式サイトに「GPT‑Live」というタイトルのページが公開されたことが確認されました。しかし公開時点で参照できた原文には具体的な機能説明や仕様に関する記述がほとんど含まれておらず、詳細は明らかになっていません。Hacker Newsでは小規模な議論が始まっています。

Vercel Blog·重要度 65·掲載 2026/7/9 06:22
ワンポイントGrok 4.5がAI Gatewayに追加、料金上乗せなしで利用可能
VercelのAI Gatewayで、xAIの新モデル「Grok 4.5」が利用可能になりました。コーディングやSTEM分野向けに設計されたモデルで、テキストと画像入力に対応し、推論の深さを調整できる点が特徴です。AI Gatewayを通じて、料金上乗せなしで利用できます。

Zed·重要度 72·掲載 2026/7/9 06:21
ワンポイントTelescope風プレビュー付きピッカーがついにZedに搭載
エディタZedのプレリリース版v1.9.0-preで、Neovimの人気プラグインTelescopeを彷彿とさせるリサイズ可能なファイル/テキストファインダーとライブプレビュー機能が追加されました。あわせてAgent Panelのスレッド内検索やGit Panelの操作性改善など、多数の機能追加とバグ修正が行われています。
Azure Blog·重要度 72·掲載 2026/7/9 06:21
ワンポイントClaude in Microsoft FoundryがGA化、AzureとNVIDIA GB300で本番運用へ
MicrosoftはAzure Blogで、Anthropic製の大規模言語モデルClaudeをMicrosoft Foundryで一般提供(GA)したことを発表しました。ホスティング基盤にはAzureと最新のNVIDIA GB300 Blackwell Ultraが採用されています。これにより、エージェント開発の実験段階から本番運用までの移行がより迅速に行えるとされています。

GitLab Blog·重要度 65·掲載 2026/7/8 19:22
ワンポイントClaude Sonnet 5、全ベンチマークタスクを完走した初のモデルに
GitLabは、AnthropicのClaude Sonnet 5をGitLab Duo Agent Platformの全ティア・全デプロイメントモデルで提供開始しました。GitLabの評価スイートで全ベンチマークタスクを完了した初のモデルであり、前身のSonnet 4.6と比べて課題解決率や信頼性が向上しています。開発者は用途に応じてモデルを使い分けることで、コストと品質のバランスを取ったエージェントワークフローを構築できます。

vLLM·重要度 75·掲載 2026/7/8 19:21
ワンポイントCUDA_VISIBLE_DEVICES自動設定を廃止、device_ids引数へ移行
vLLMプロジェクトはv0.24.0をリリースしました。256人のコントリビューターによる571件のコミットが取り込まれ、MiniMax-M3への新規対応やDeepSeek-V4の性能最適化、Model Runner V2の機能拡張、そしてCUDA_VISIBLE_DEVICESの内部設定廃止などが盛り込まれています。あわせて複数のセキュリティ修正も実施されました。

Hugging Face Blog·重要度 65·掲載 2026/7/8 14:54
ワンポイントIBM ResearchがJavaフレームワーク移行AIエージェントの新評価基準を公開
IBM ResearchがHugging Face Blogにて、AIエージェントによるエンタープライズJavaフレームワークの移行能力を評価するベンチマーク「ScarfBench」を公開しました。実務で発生しがちなレガシーJavaシステムの移行作業をAIエージェントがどこまで自動化できるかを測る指標として位置づけられています。

Redis Blog·重要度 65·掲載 2026/7/8 14:54
ワンポイントコンテキストを増やすほど回答精度が落ちる逆説をRedisが提起
Redis Blogの記事は、LLMに渡すコンテキストを増やすと逆に回答の質が下がるという逆説的な現象を取り上げています。トークン数を増やすことと、モデルに渡す情報の「信号(シグナル)」の質を高めることは別問題だという論点が提示されています。記事タイトルが示す通り、量ではなく密度が鍵になるという視点が示されています。
Redis Blog·重要度 65·掲載 2026/7/8 14:53
ワンポイントAIエージェントの記憶を「短期」と「長期」に分けて設計する発想
Redisが公式ブログで、AIエージェントが会話や処理をまたいで情報を蓄積・再利用するための「メモリ」の仕組みについて解説しています。エージェント開発における記憶管理の重要性と、Redisを用いた短期・長期メモリの構築という切り口が紹介されています。

Hugging Face Blog·重要度 72·掲載 2026/7/8 14:52
ワンポイントGemma 4がHugging FaceとCerebrasでリアルタイム音声AIに対応
Hugging FaceとCerebrasが、Googleの新しい言語モデル「Gemma 4」をリアルタイム音声AIに統合する取り組みを発表しました。両社の連携により、モデルの公開・共有基盤と高速推論基盤を組み合わせた音声AI活用が進む見通しです。

Ollama·重要度 72·掲載 2026/7/8 14:52
ワンポイントGemma 4がApple Silicon上で平均約90%高速化
OllamaのバージョンアップによりApple Silicon上でのGemma 4の推論速度が大幅に向上しました。マルチトークン予測(MTP)技術の活用により、コーディングエージェント向けベンチマークで平均約90%のトークン生成速度向上を実現しています。設定不要で自動的に有効化される点も特徴です。